先说 Matt Pocock 是谁
如果你写过 TypeScript,大概率刷到过他的脸。Matt Pocock 是 Total TypeScript 和 AI Hero 的创始人,现在全职做开发者教育。
他的路径很不常规:大学学的是声乐,在伦敦教了六年唱歌、口音和公开演讲,2018 年才正式转行写代码。之后在 Stately 做过 XState 核心团队(写文档、做类型生成),又在 Vercel 做开发者教育(Turbopack 初版文档有他的份),顺手写了 ts-reset 这种被大量项目引用的工具库。
转行晚、非科班,反而是他的优势——他极擅长把复杂的东西讲成人话。所以他的东西基本都是”流程”,不是”框架”。
他对 AI 编程的判断也很直接:写具体实现这件事已经被 AI 吃得差不多了,人剩下的价值是把控结构和取舍。用他的话说,代码库就是 Agent 生存的环境——环境脏、说明缺、测试和检查都没有,再强的模型进去也只能瞎转。
于是他把自己那套软件工程老规矩,拆成一段段可编辑的小流程放进 mattpocock/skills:先逼问需求(grill-with-docs)、落成规格(to-spec)、拆成票(to-tickets)、一张张实现(implement)。
这次 1.3 更新,为什么值得看
同样是用 AI 写代码,为什么有人半天搞定,有人折腾一天?mattpocock/skills 工作流 1.3 更新了三个新技能,实测一个比一个狠——尤其是最后一个,我认为是最该天天用的。
你是不是也这样:AI 提的 PR 密密麻麻看不懂重点?ticket 只能一条条手动跑?AI 改来改去就是改不到点子上?这篇逐个拆解这三个新技能是怎么治这些毛病的。
最后还讲一个几乎所有人用这套工作流都会犯的错误,很多人从第一天就在犯——看到最后,对照一下自己中招了没。
看完之后我没直接写笔记,而是把三个都真跑了一遍:装技能、造一个会报 500 的 bug、开三条分支并行改、加一个提交前的自动检查。所以下面凡是写”实测”的,都是真的跑了,不是转述。
(情况先交代一句:我机器上没有 Claude Code,用 junie 加载同一份 SKILL.md,模型走 DeepSeek。所以是”真跑了”,但不是原版斜杠命令,会影响一两处细节,下面会标。)
三个技能插在哪
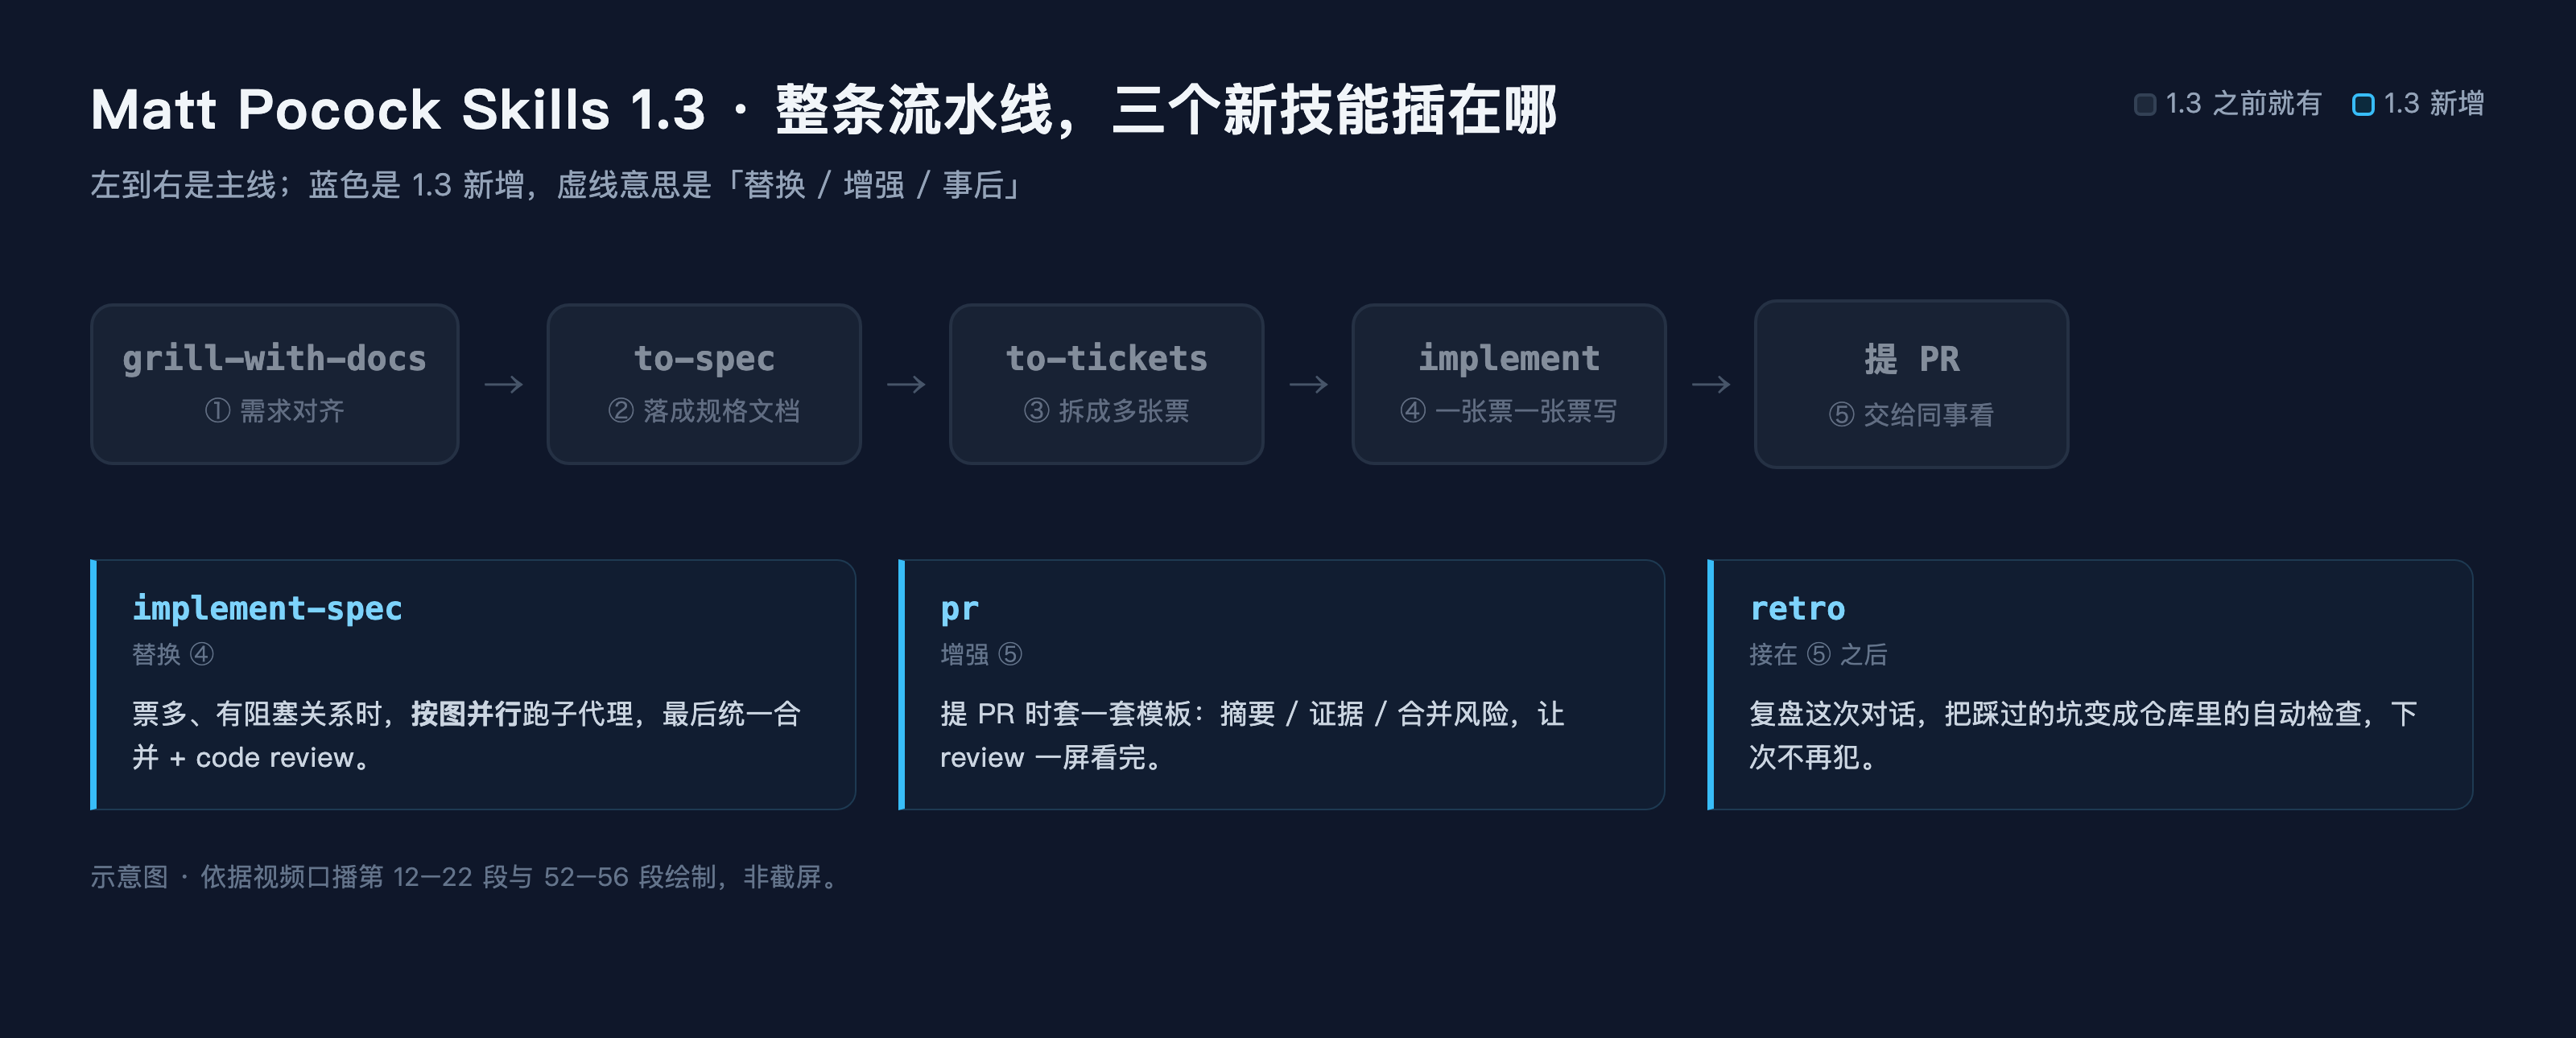
原来这套工作流是四个技能串成一条线:问需求 → 落成文档 → 拆成票 → 一张张写。1.3 加的这三个不是新环节,是三个卡点:
/pr卡在提 PR 那一刻,解决 AI 写的描述没法看;/implement-spec替换”一张张写”,解决票多了一个个跑太慢;/retro落在 PR 之后,解决同样的错下次还犯。
/pr:终于有人管管 AI 写的 PR 描述了
你肯定见过这种 PR:改了 17 个文件,描述前 30 行在解释它怎么想的,你想知道”到底改了啥、有没有坑”,得自己扒。
/pr 干的事很简单,给一套固定模板,四样东西:
摘要要”最小视图”——能画成 4 行伪代码就别贴 200 行 diff。
证据要 before 和 after,而且必须是当场跑出来的。这是整个技能里最值钱的一条。
门:这次改动是单向门还是双向门。单向门是有去无回(删数据、改表结构、改对外接口),双向门是 git revert 一句就回去了。
范围:影响多大,技能要求写成一个词。
作者举了两个自己的例子,对照着看特别清楚:一个 PR 是双向门但影响整个全栈,所以要好好看;另一个也是双向门但只影响一个库,范围小,自己评估下就能合。同样是双向门,结论完全不同——这就是这套模板真正的用处,不是让描述好看,是让”要不要细看”这个判断变便宜。
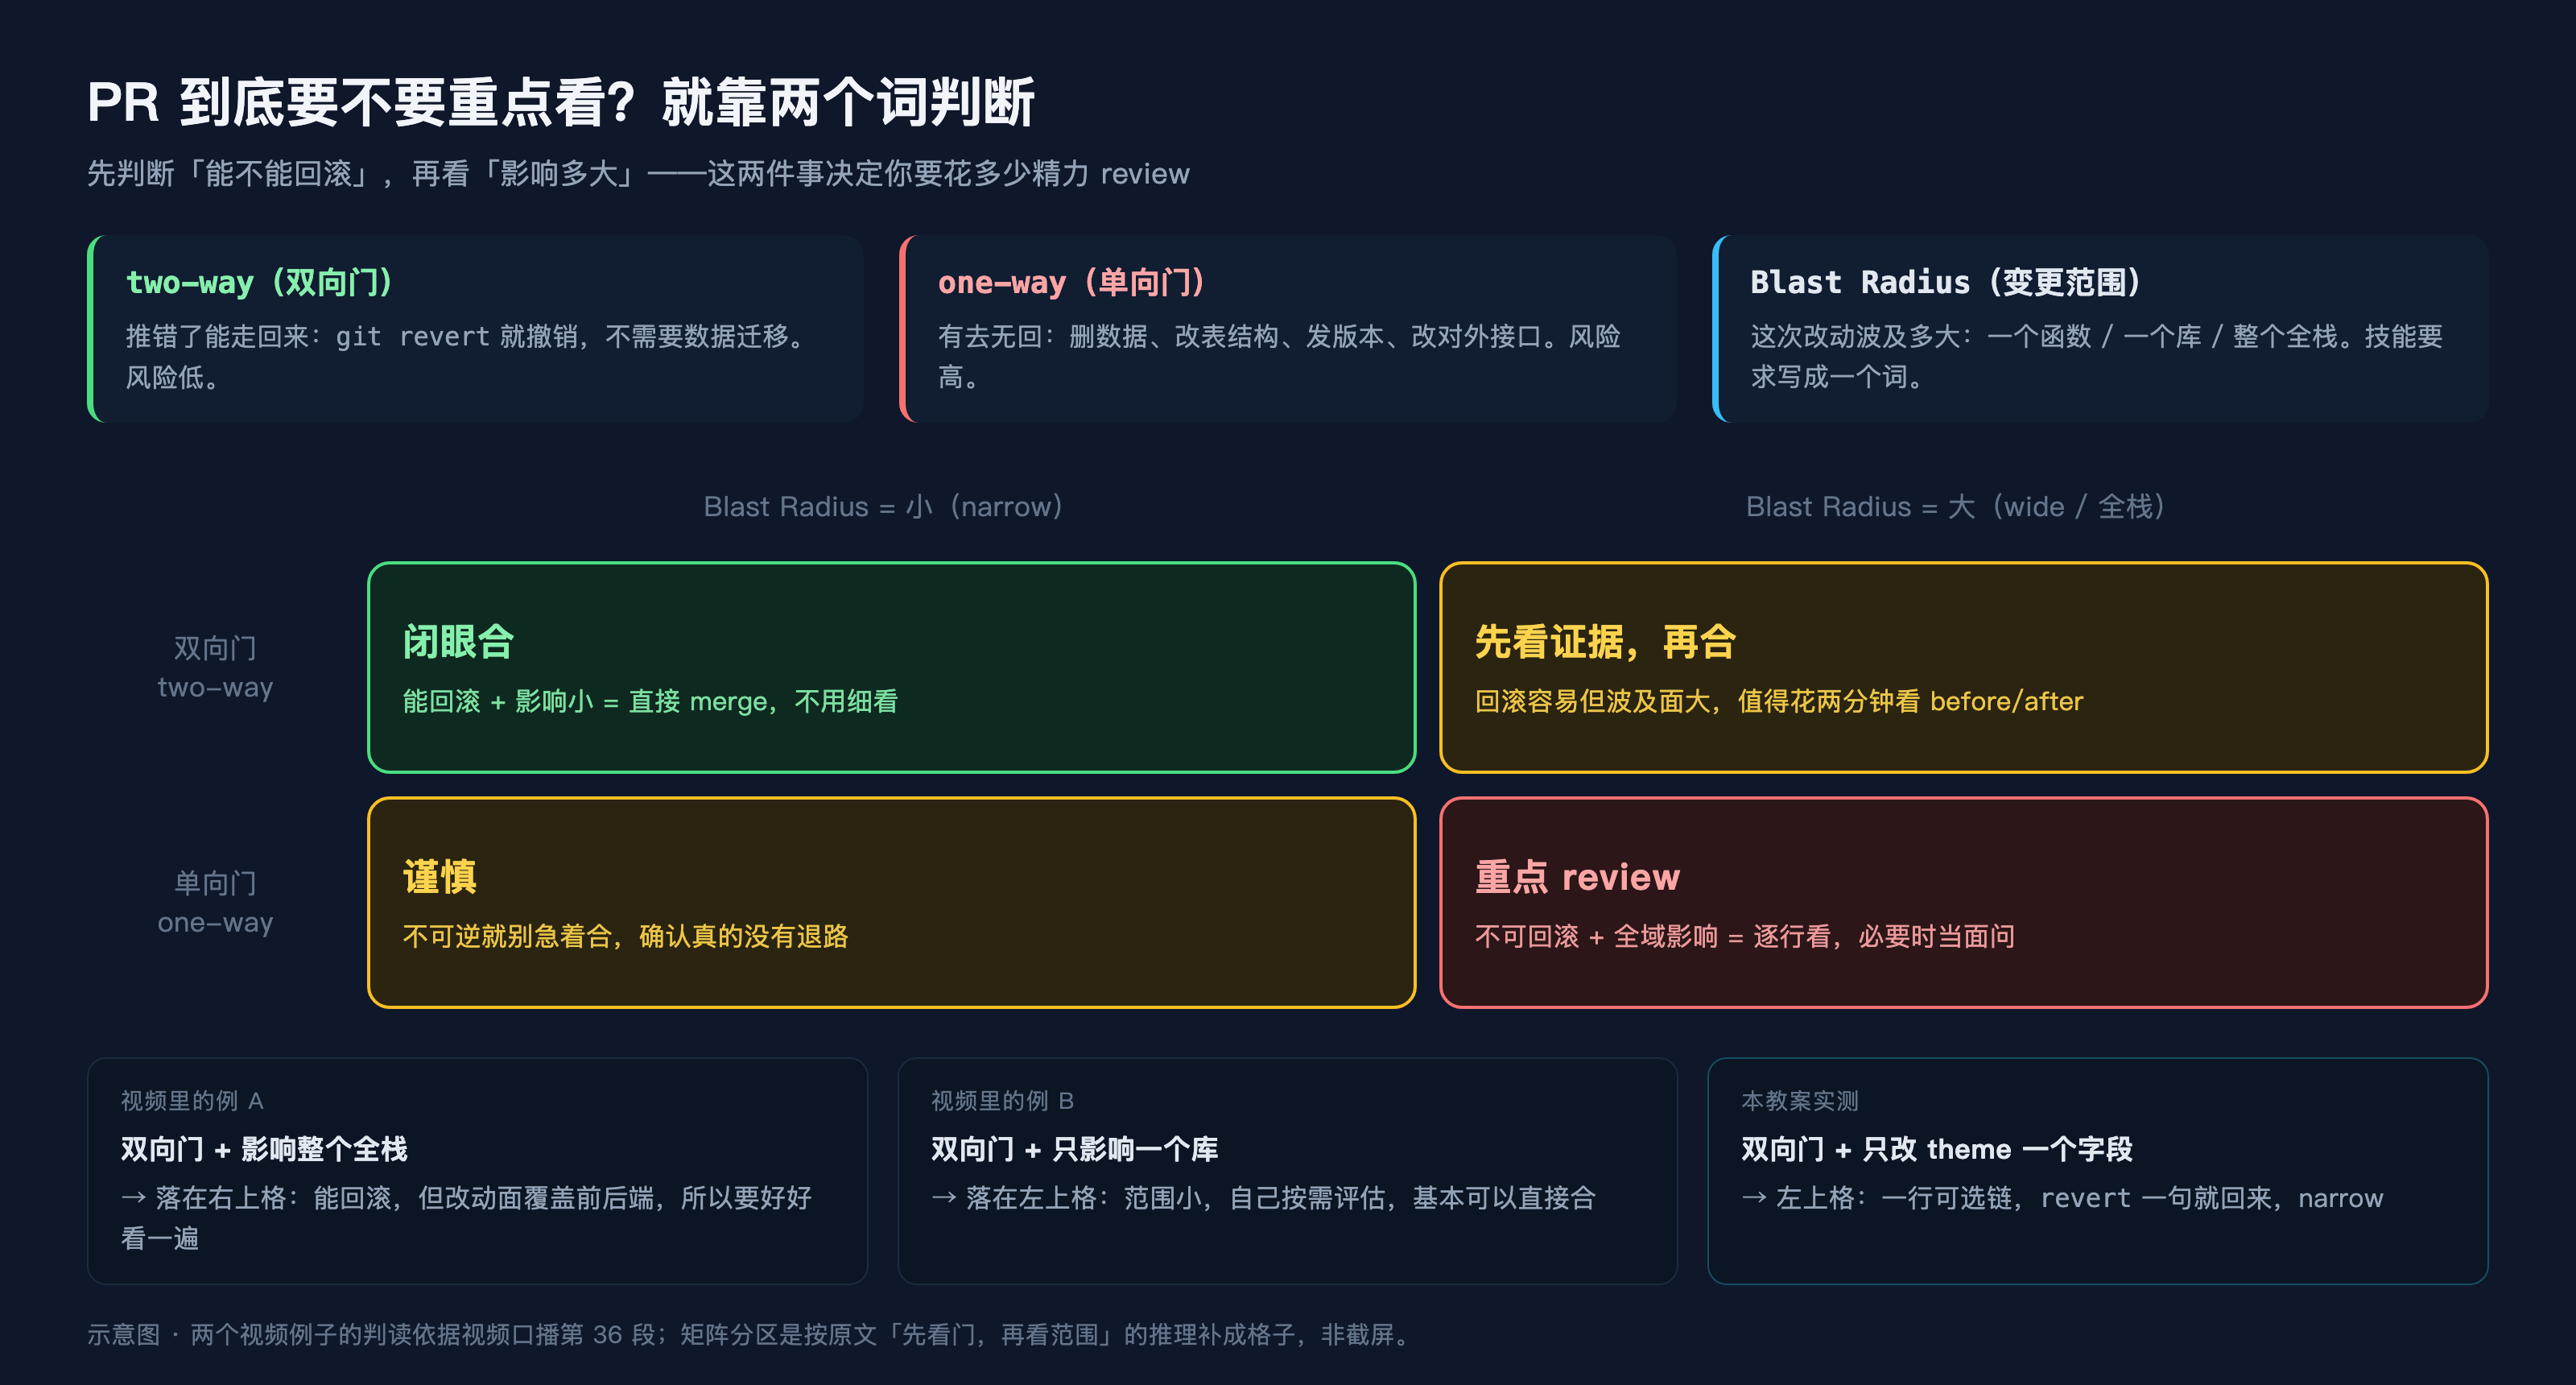
看别人的 PR 时顺序要倒过来:先看门和范围,值得看才看证据,最后才看摘要。反着来最亏,你花十分钟读完一大段摘要,最后发现是单向门根本不敢合。
我自己跑的那次
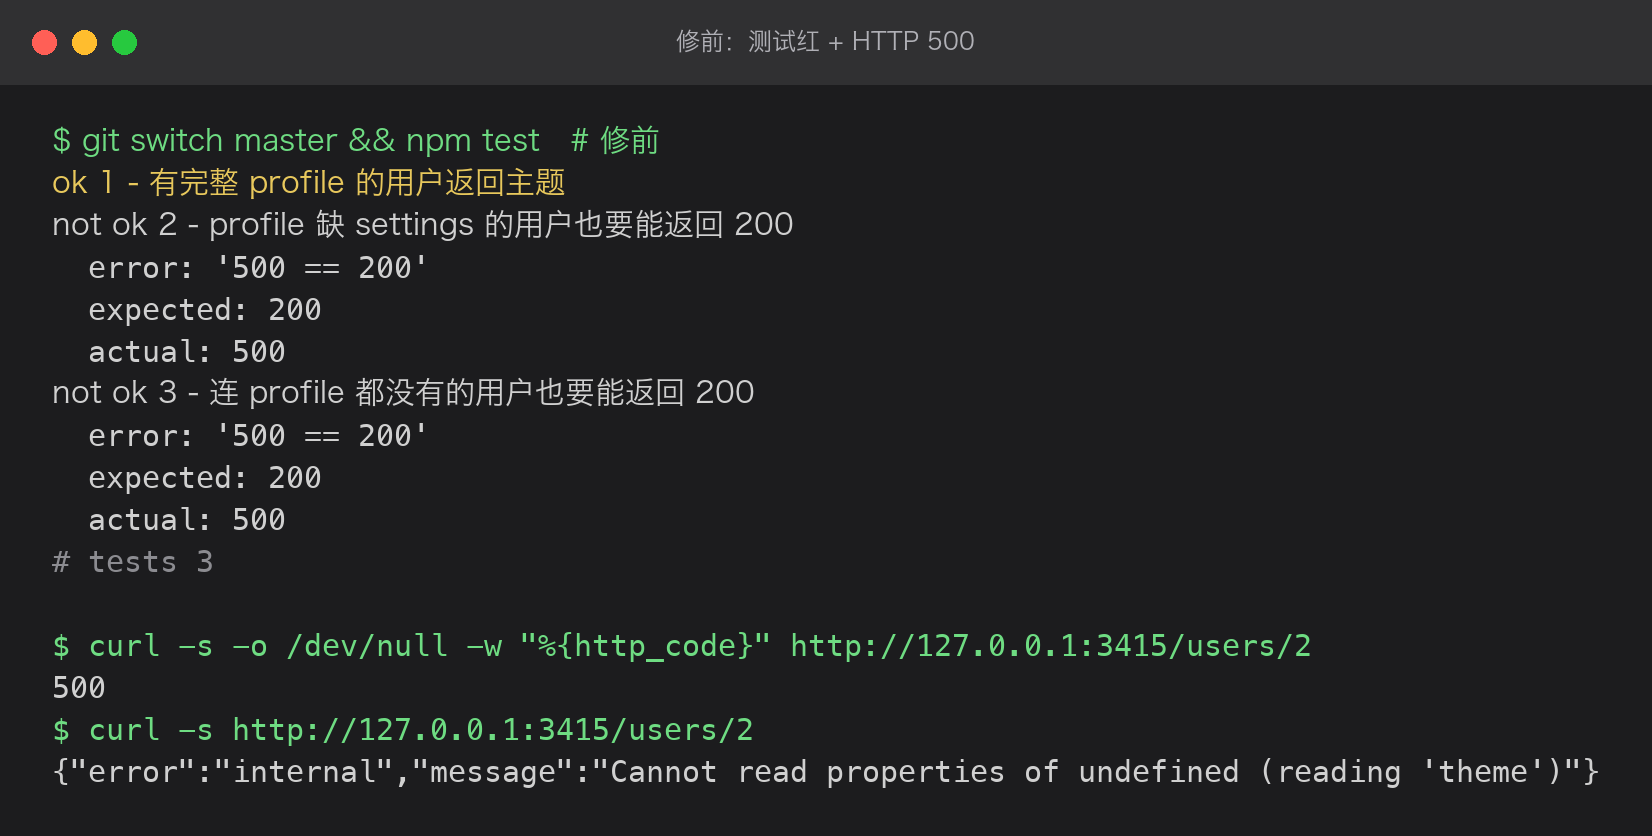
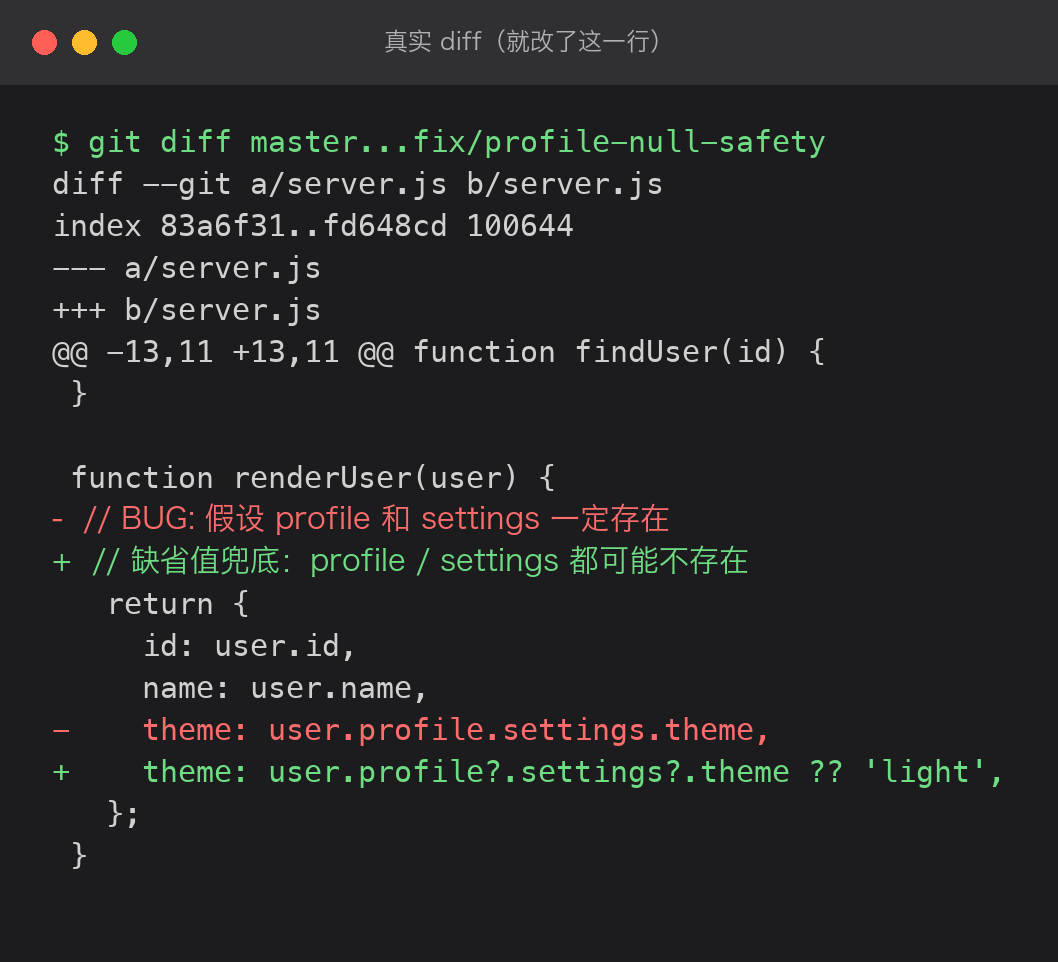
我造了个 30 行的 Node 服务,三个用户里一个数据完整、一个缺 settings、一个连 profile 都没有。代码直接读 user.profile.settings.theme,后两个必崩。
修之前先跑一遍,两条测试红,curl 回来的是真 500:
改法就一行,这是仓库里真实的 diff:
3 个测试全绿,两个原本崩的 URL 都变 200,theme 兜底成 light:
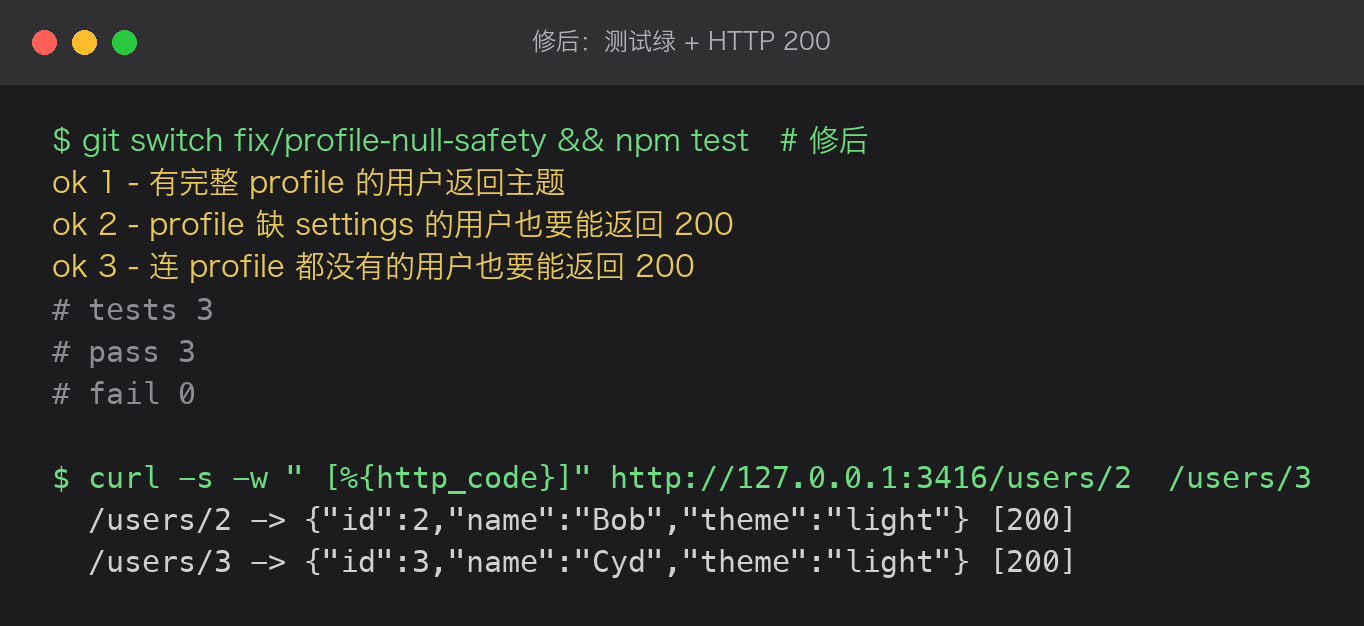
然后让 agent 挂 pr 技能写描述。有个细节值得说:它没有直接抄我给的输出,而是自己把 master 分支起了一遍服务、跑 curl 复现了 500,再写进 Evidence。原文那句”生成 PR 的时候它会自己去验证”是真的。
它交出来的长这样(节选,⋯ 那行是我省掉的 live 服务实测):
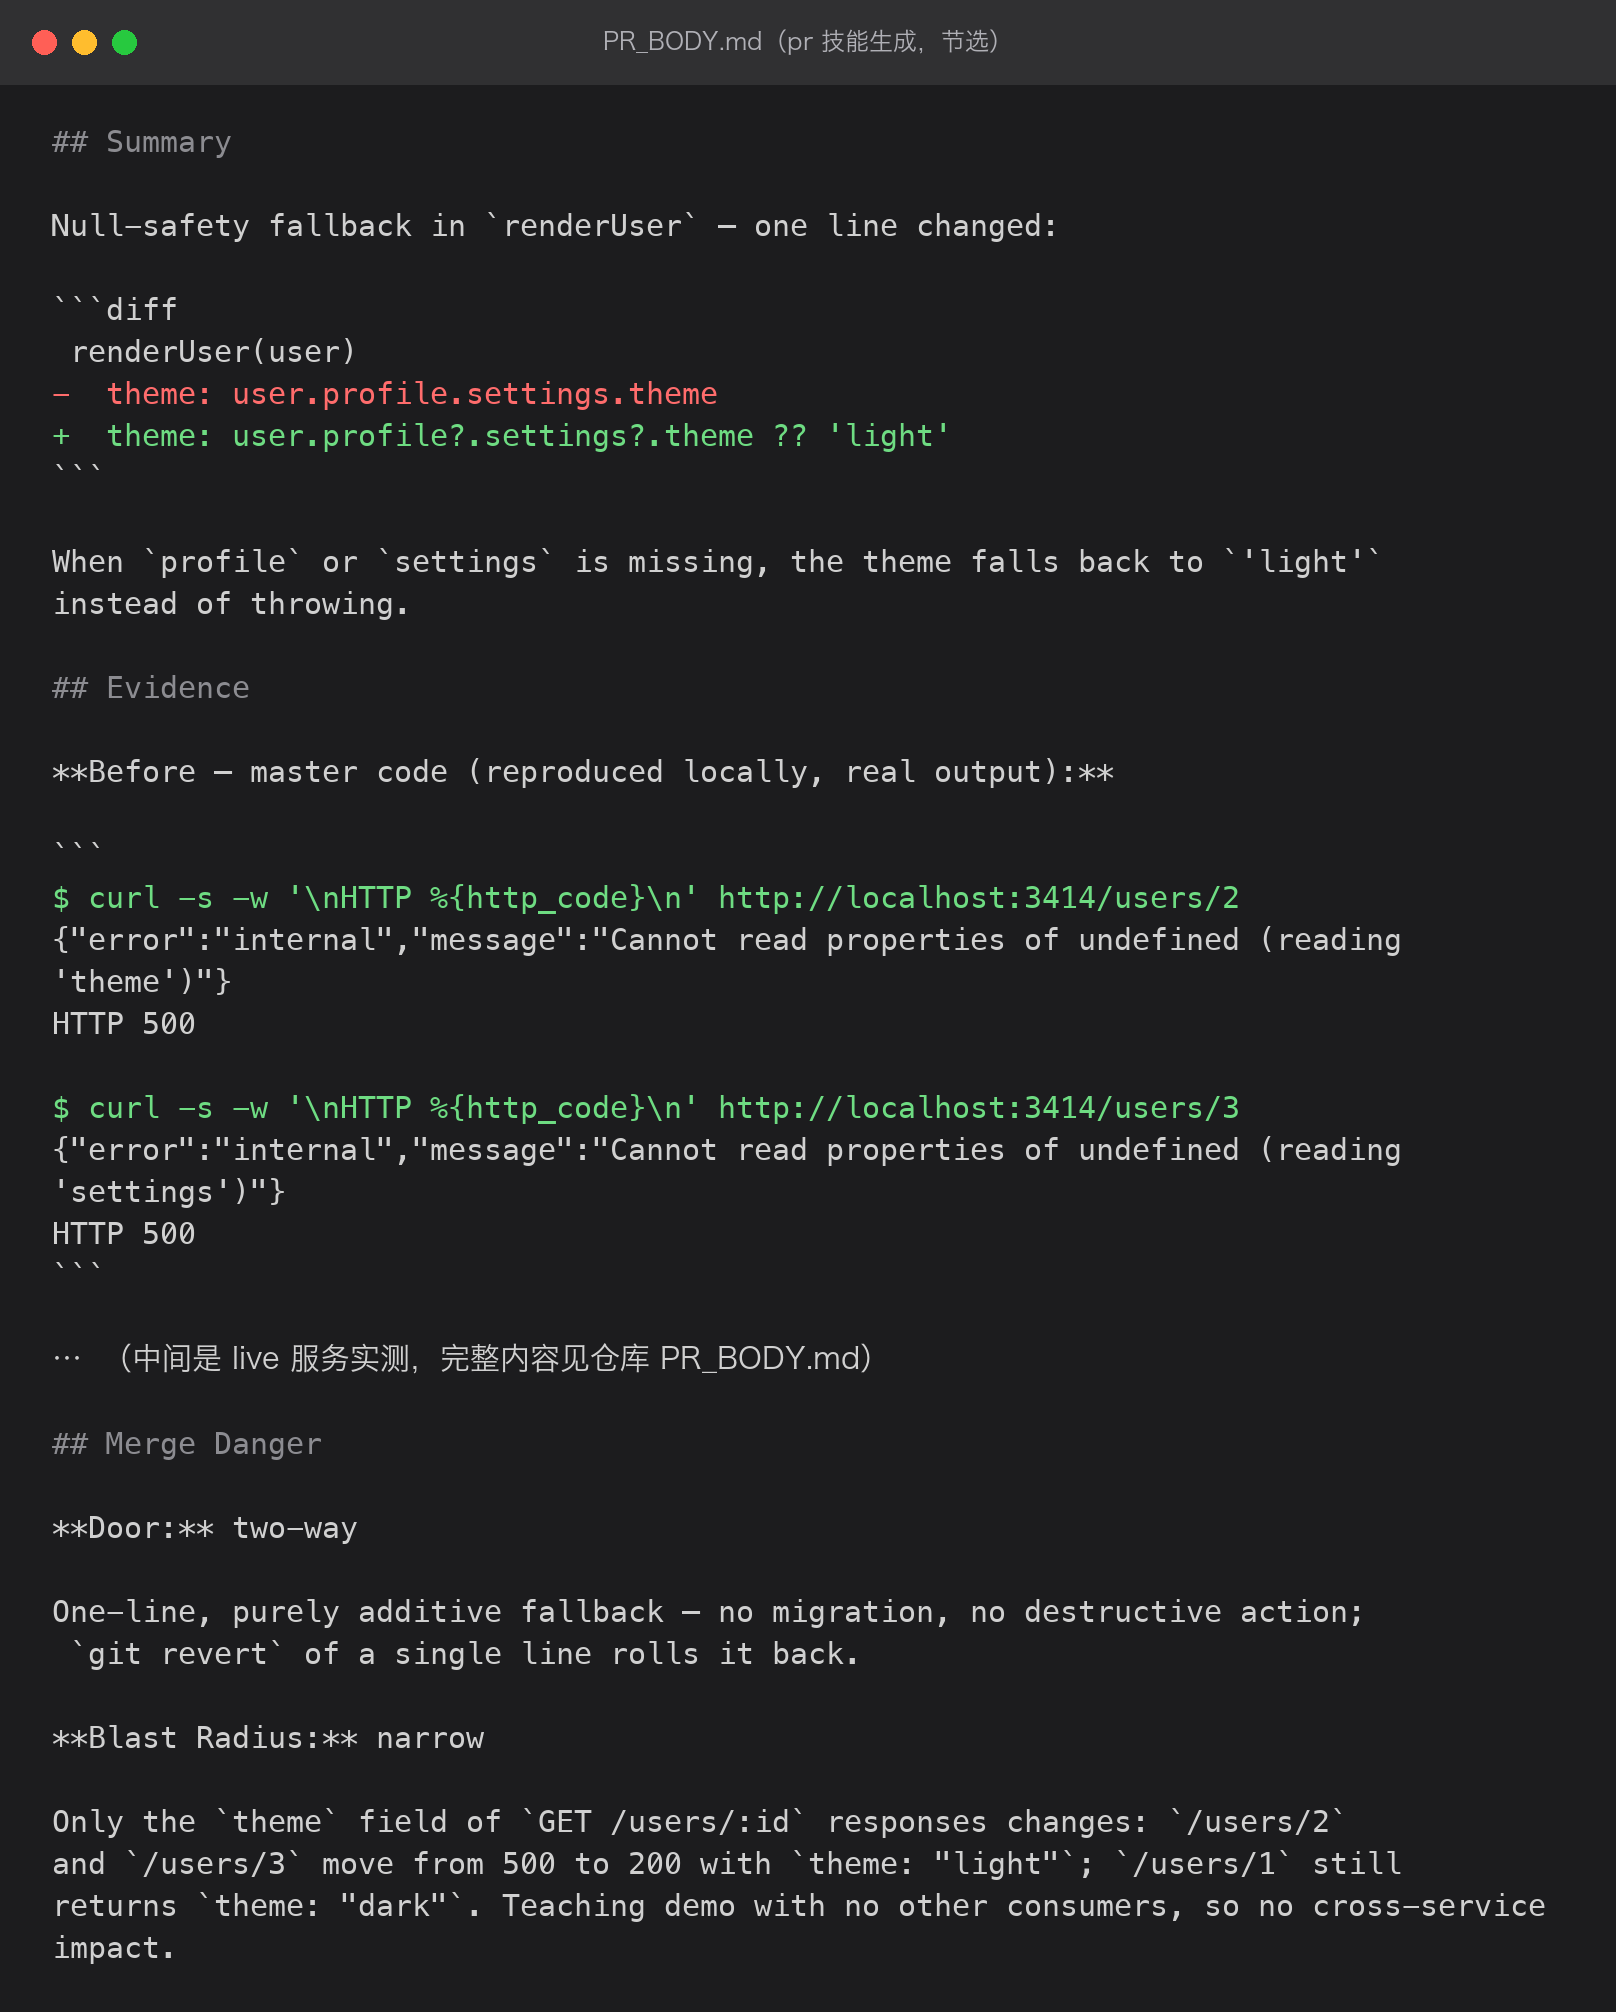
一段摘要、真跑出来的 before/after、两个词的判断。这个 PR 落在”双向门 + 范围小”那个格子,按原文说法就是闭眼合。
用之前必须知道的两件事
第一,/pr 敲不出来。 它不是斜杠命令,是”模型自己判断该用才用”的那种。我第一次敲没反应,以为自己装错了。想稳定触发只有两条路:在 AGENTS.md 里写一句”提 PR 时必须用 pr 技能”,或者直接说”按 pr 模板写 PR 描述”。
第二,它会读你仓库根目录的 GLOSSARY.md 来对齐术语。 没有这个文件,它就用不上你们的行话。而且 v1.3 把这个文件从 CONTEXT.md 改名成了 GLOSSARY.md,老仓库不改名,它会当成空文件,把你的术语库盖掉。
/implement-spec:把票当图,别当清单
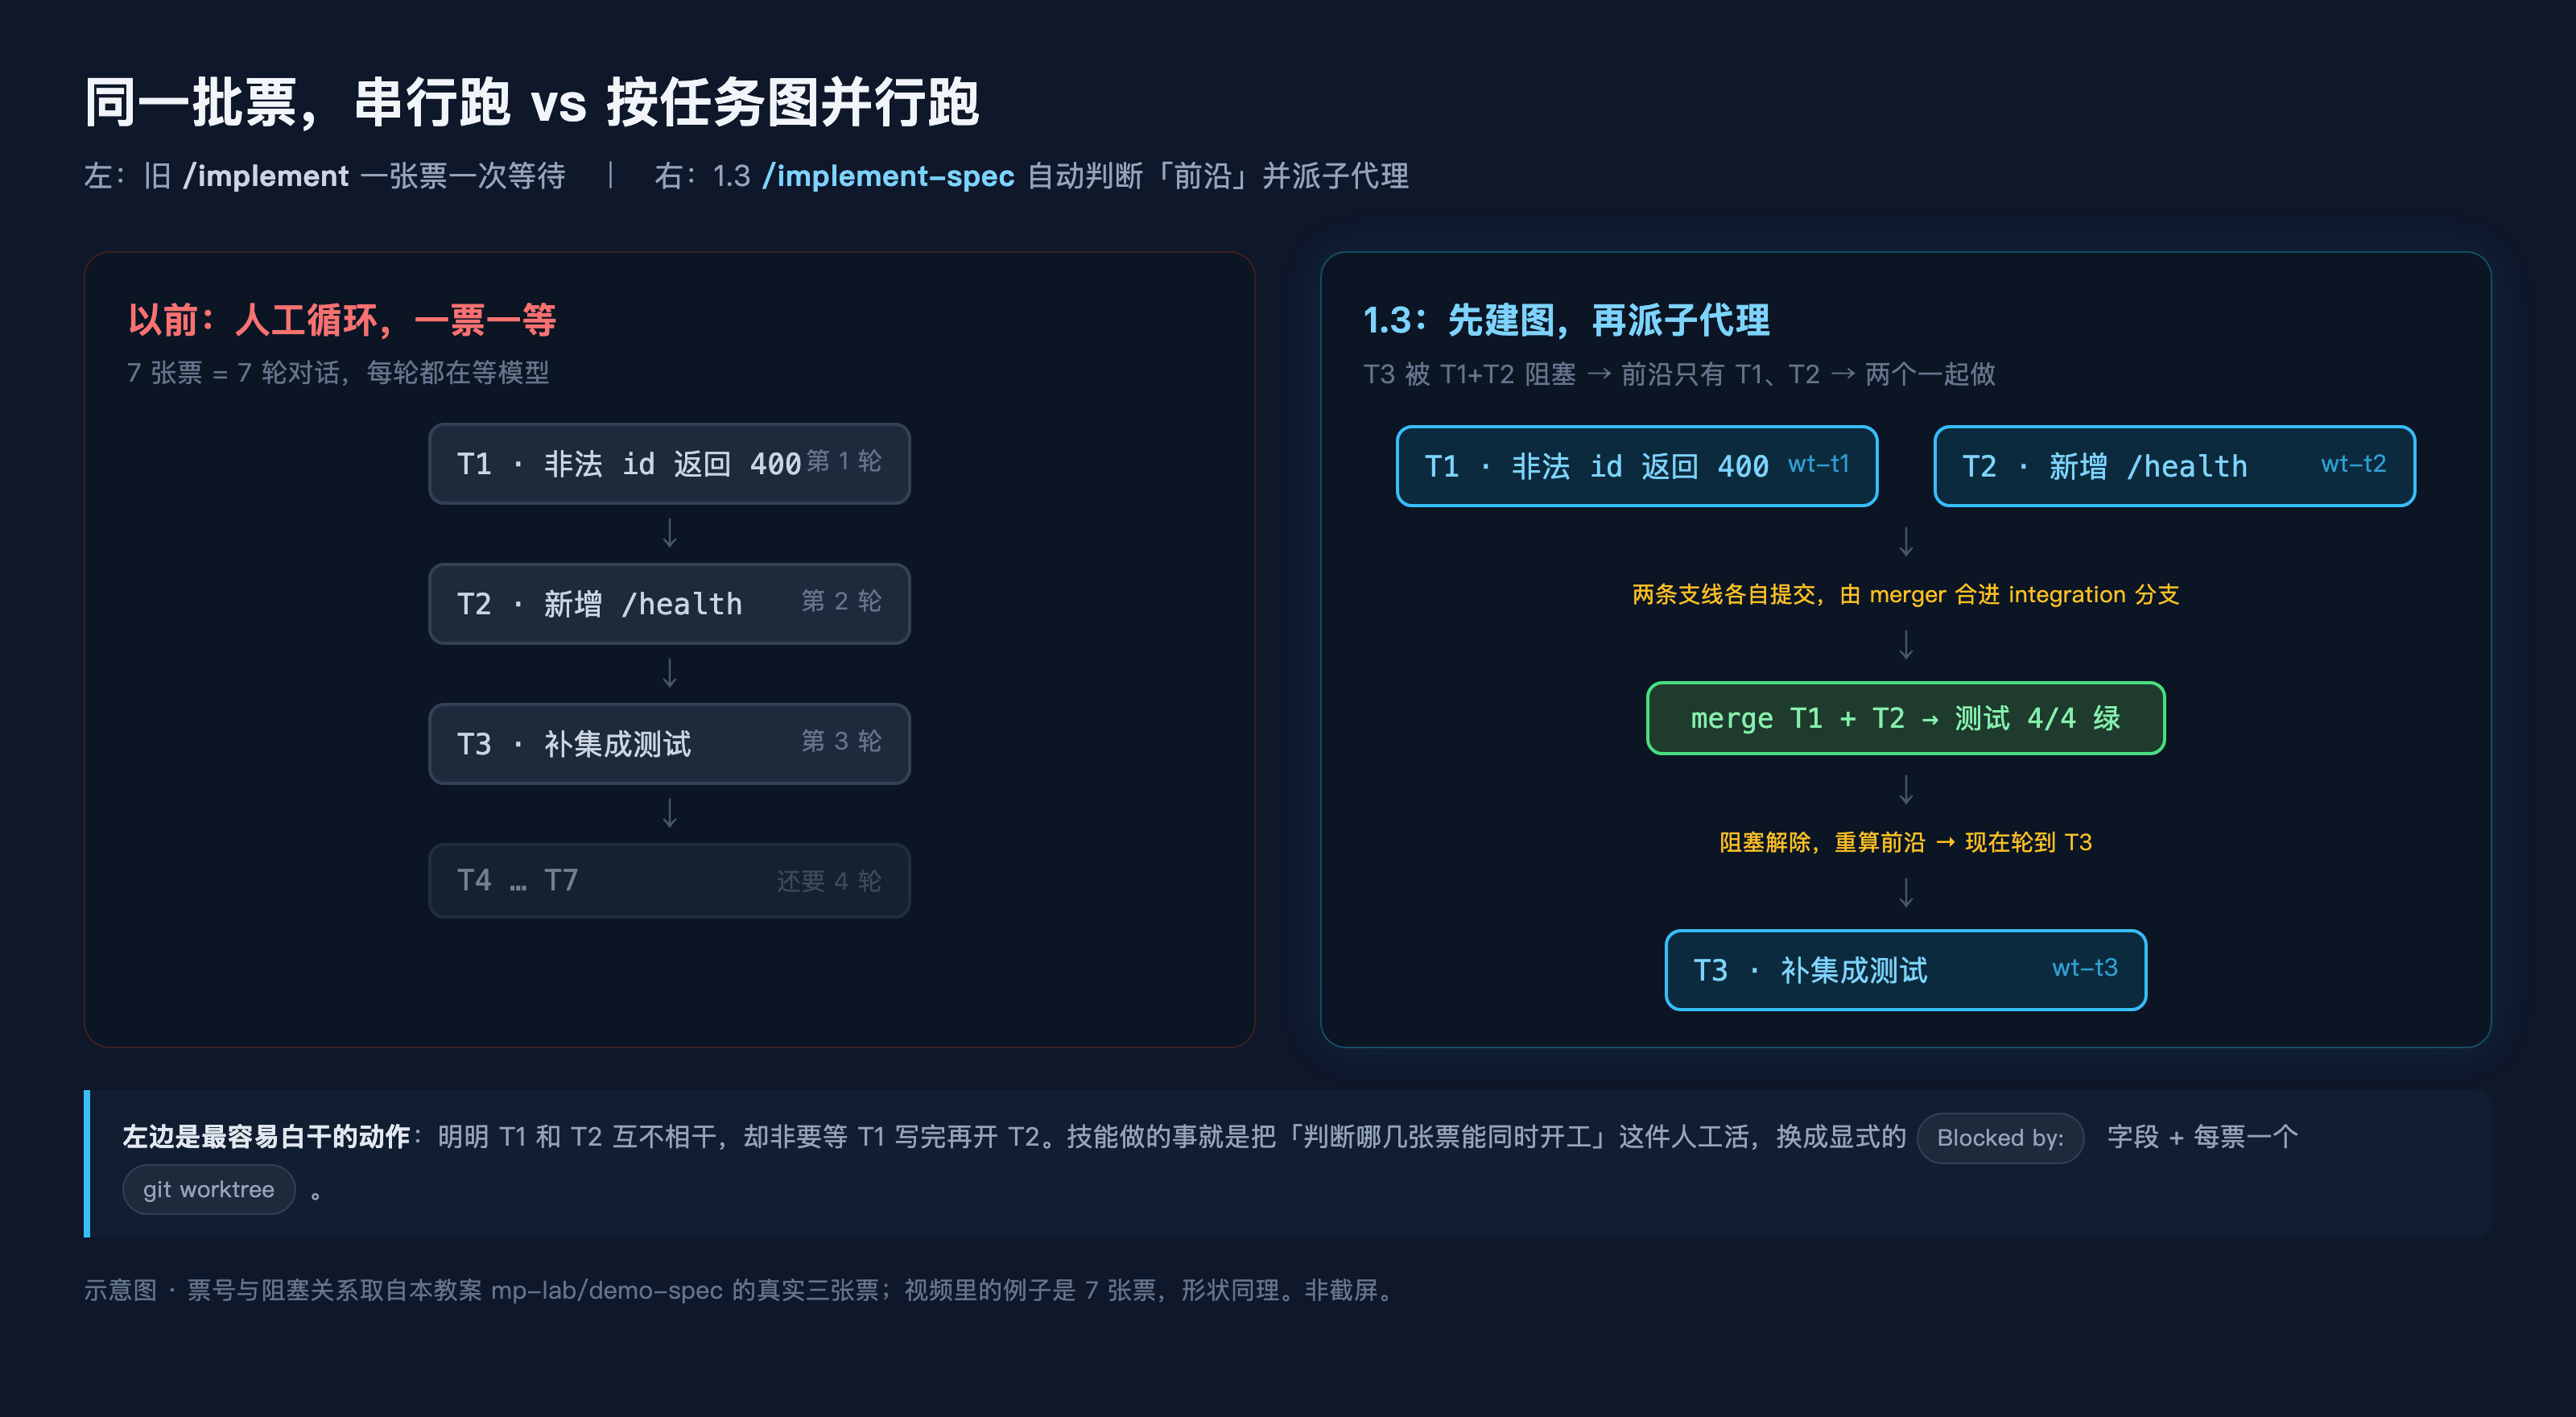
原来是这么干的:/implement ticket1,等它写完,再 /implement ticket2,一个个来。7 张票就是 7 轮对话,每轮都在等模型。
慢的不是代码写得多,是你在等。而且其中好几张本来根本不用等。
/implement-spec 做的事就一件:把”判断哪几张票能同时开工”这件人工活自动化。票上写 Blocked by:,它算出当前没被阻塞的那批(就是”前沿”),派子代理去并行做,做完合并,再重算前沿,图不空就继续。最后统一 code review,再清掉临时工作目录。
我自己跑的那次
三张票:T1 让非数字 id 返回 400,T2 加个 /health 探针,T3 给前两个补集成测试。T1 和 T2 的 Blocked by 都是”无”,T3 写的是”T1, T2”。
所以前沿是 2。开了两个 git worktree,各跑一个子代理——三张票的阻塞边,和当时真实的 worktree 列表:
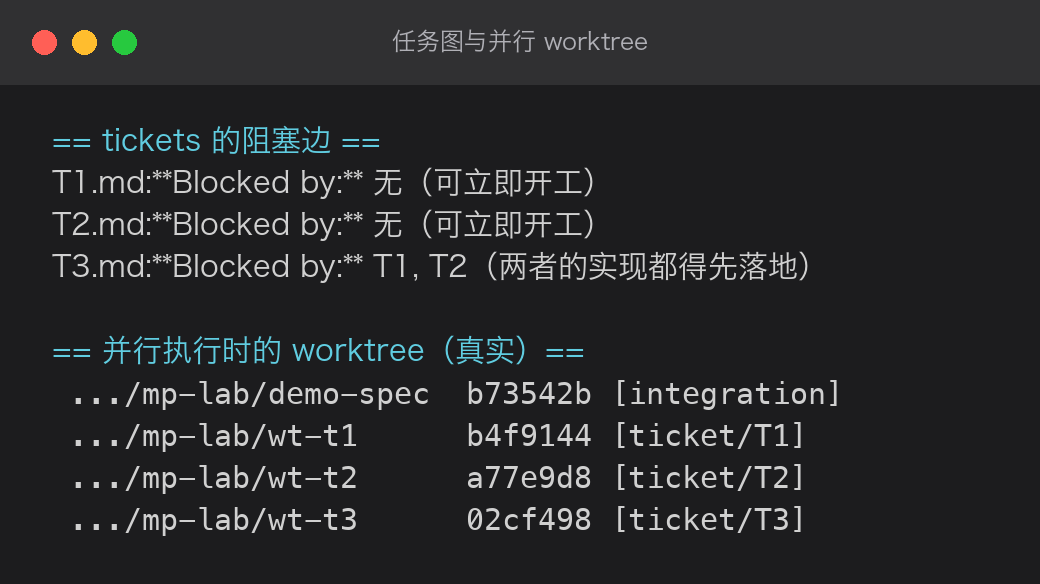
T1、T2 各自提交,合进 integration,测试 4/4 绿。这时候 T3 的阻塞才解除,第三个 worktree 才开。最后 6/6 绿,git log --graph 长这样:
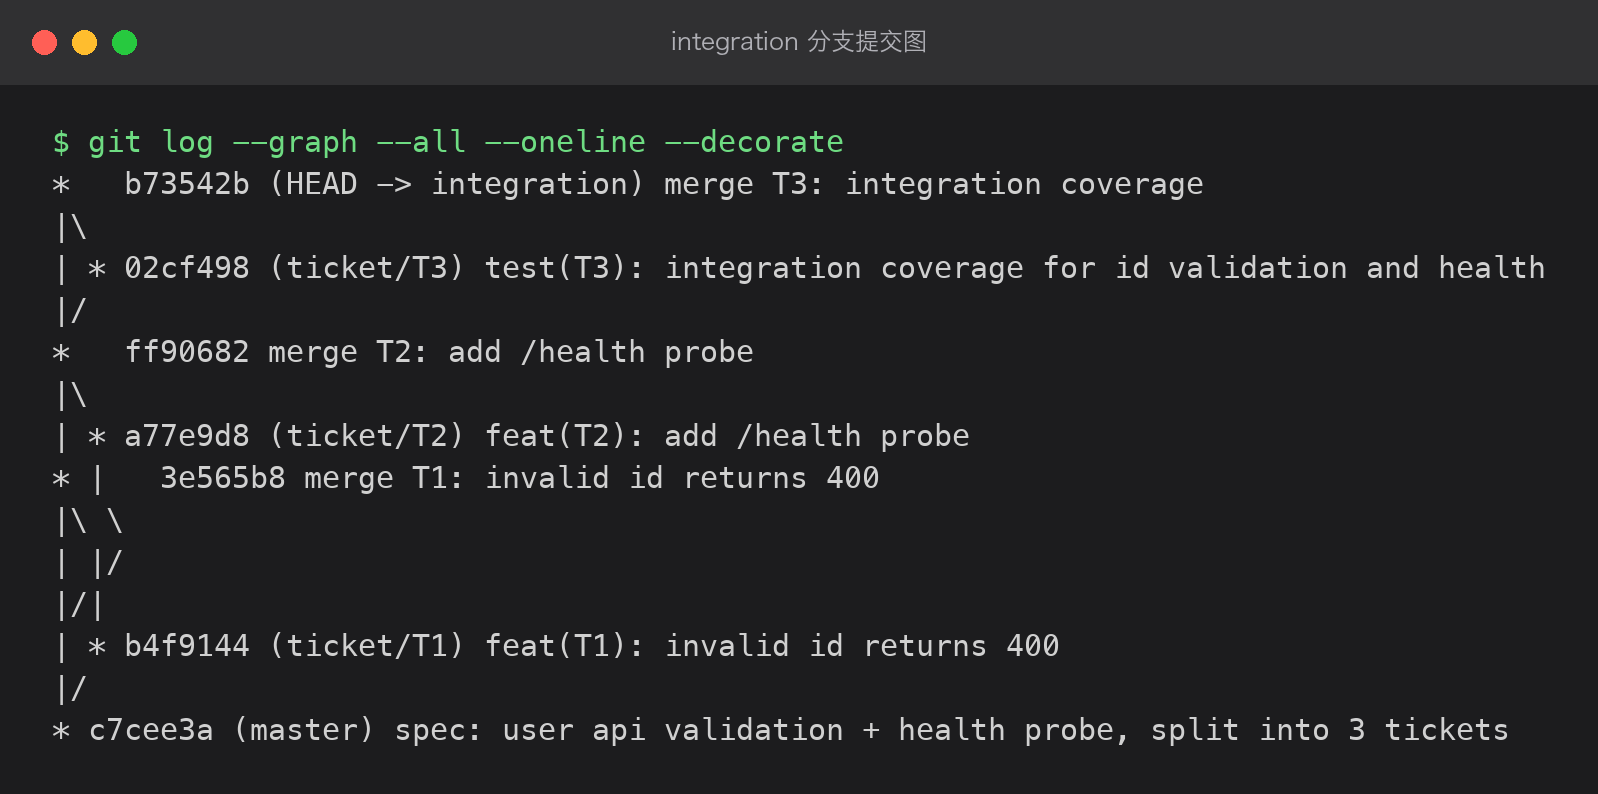
两条支线各自跑完再汇合。这个形状就是验证标准——如果你做完发现 git log --graph 是一条直线,说明根本没并行,要么票没建对,要么技能没用上。
三个容易踩的点
它的 Blocked by 必须是真依赖,不是”步骤顺序”。 如果你写成”第一步、第二步、第三步”,那它就只能一张张来,白装。
它有个硬前置:issue tracker。 没配过的话,它会直接让你先跑 setup-matt-pocock-skills,不会硬着头皮往下做。另外它内部要调 tdd 技能,装的时候别只装 implement-spec 一个。
它的清理不彻底。 最后一步只说了清 worktree,没说要删分支。我按它做了一遍,“清理”之后目录干净了,但 ticket/T1、T2、T3 三条孤儿分支还在。得自己补一句 git branch -D。
顺带一个判断:这技能不是万能的。原文说得很直白,功能简单就直接用 /implement。2 张票、彼此还没依赖,用 implement-spec 纯属加戏。
/retro:三个里我最推荐的
它复盘的不是代码,是你让 AI 干活的那个环境。问的是:这次为什么绕了远路?是缺个说明文件、缺个自动检查,还是工具太笨重?
作者跑那次,它找出的三条是:仓库没有任何前端规范、经常靠截图让 AI 修 bug(说明 AI 拿不到运行时信息)、以及一份按优先级排的修复清单。三条都不是”这次代码写错了”,而是”下次还会错”。
它有一句话我特别喜欢:能造一个自动检查,就别写一条规范文档。机械性错误写进文档等于没写——没人读,AI 也不一定读。只有真需要判断的(“和周围代码风格保持一致”)才值得写文档。
我自己跑的那次
我让它复盘那个 demo 仓库,它写了 5 条,按严重程度排序。最狠的一条是:
仓库有可用的
npm test(3 个用例),但没有任何 CI、pre-commit 或 lint 去自动跑它。这次修的 bug 恰好已经被测试覆盖,却只能靠人手动跑,拦不住回归。
这条扎心在于:测试我写了、跑过、还绿了,但它从来不会自己跑。等于白写。
还有一条是我完全没想到的:我用 npx skills 装技能时,它建了 38 个 .claude/skills/* 符号链接并提交进 git,而 .agents/ 被我 .gitignore 了。也就是说别人克隆这个仓库,技能全是断的。这不是代码 bug,是环境 bug,正好是 retro 该管的。
关键在最后一步:先让它红一次
复盘出来的只是建议。建议不改环境,只有落地才改。
第 1 条说”测试从没被自动跑”,那就加个提交前跑测试的钩子。这个仓库里它最终长这样:
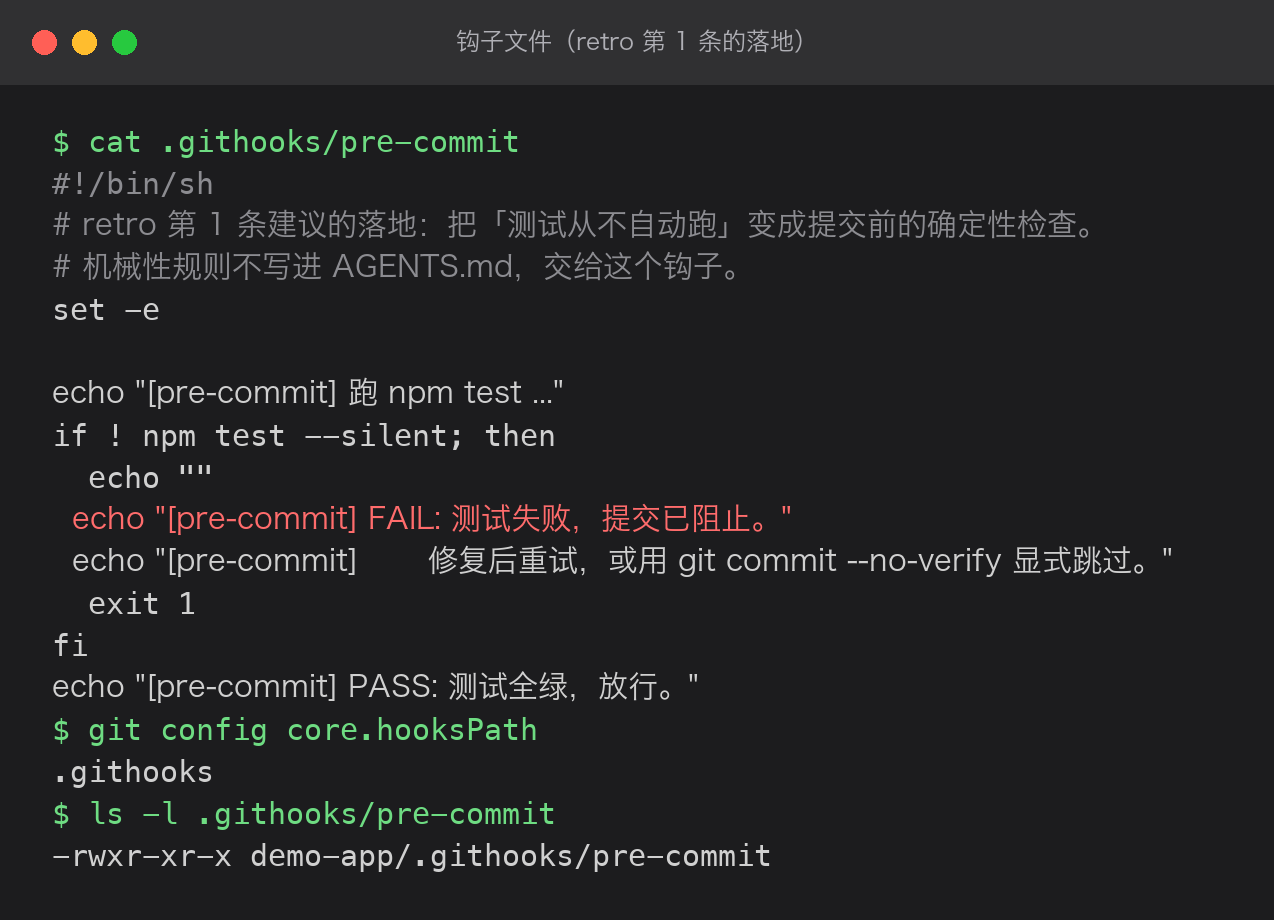
挂上只要两行:chmod +x .githooks/pre-commit 给执行权限,git config core.hooksPath .githooks 把钩子目录指过去。
然后故意把 bug 改回去,再提交一次——这是当时的真实输出:
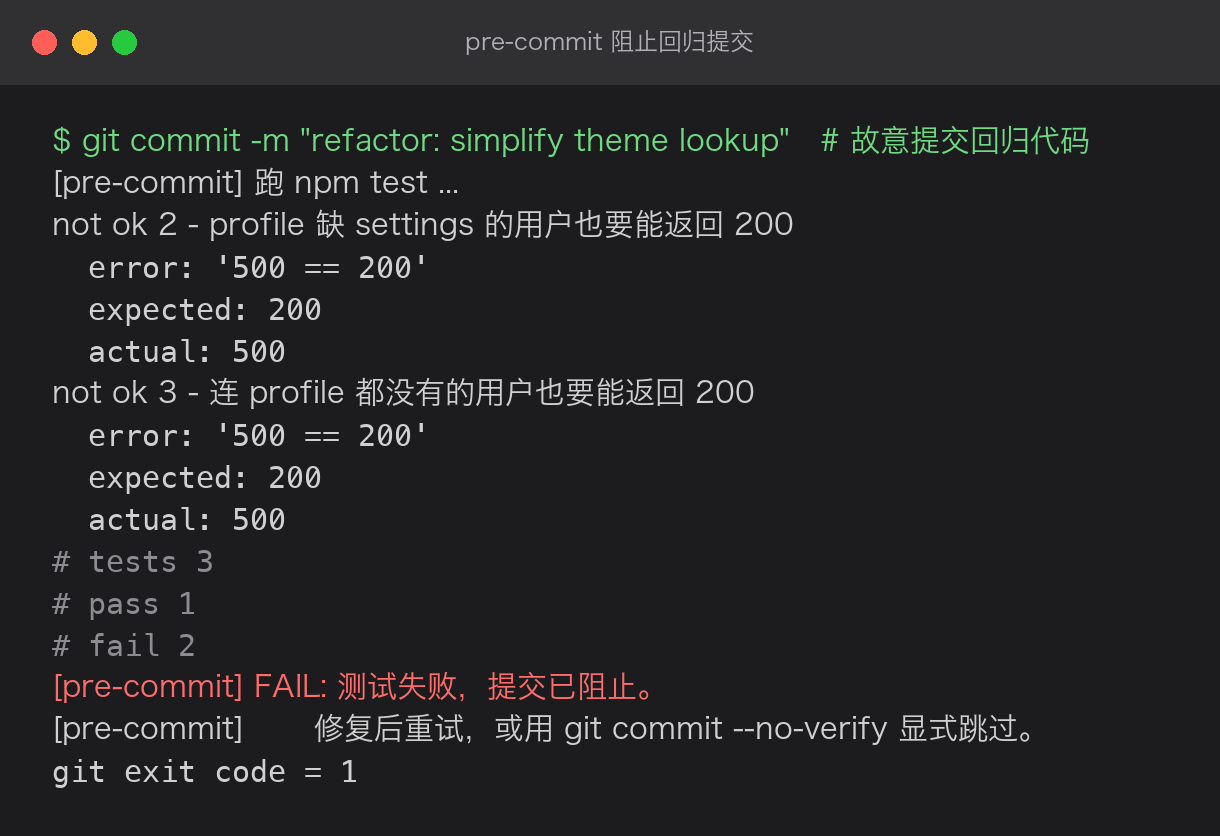
git exit code = 1,提交真的没落地。改回正确代码,放行。
为什么要故意让它红一次?因为护栏最常见的失败不是写错,是写了但从来没触发过——没执行权限、core.hooksPath 没设、路径写错,任何一个都会让它在旁边站岗一辈子还不告诉你。
(顺手一个细节:第一版钩子我用了 ✓ ✗,渲染出来是豆腐块。钩子输出老老实实用 ASCII。)
怎么装
原文全程假设技能已经装好了,一句没讲安装。这是最大的空白,也是最多人卡的地方。
空目录里 git init 之后一行就装完:npx skills@latest add mattpocock/skills --agent '*' -y。真实输出是这样,注意那个 Found 38 skills:
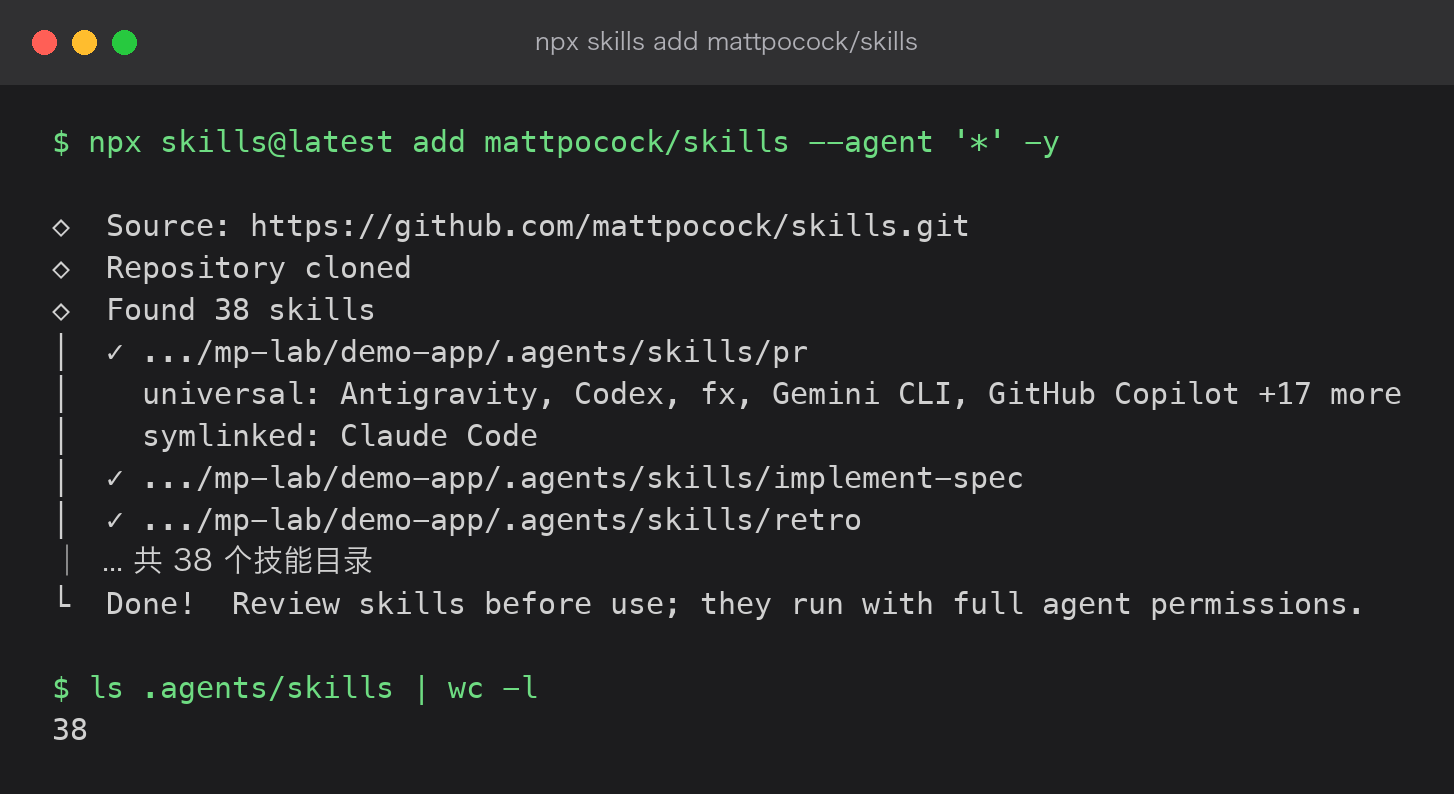
两个坑:
非交互环境必须加 -y --agent '*',不然报 Interactive prompt required but stdin is not a TTY。
--skill=pr 根本不筛选。 我老老实实传了 --skill=pr --skill=implement-spec --skill=retro 再加 -y,结果照样全量装了 38 个。想精选就别加 -y,走交互勾选。
那 38 个是怎么来的?官方文档说 27 个,那是 engineering(20) + productivity(7) 的正式集;-y 全量装会额外带上 misc(4) 和 in-progress(7)。我逐个目录数过,不是猜的。
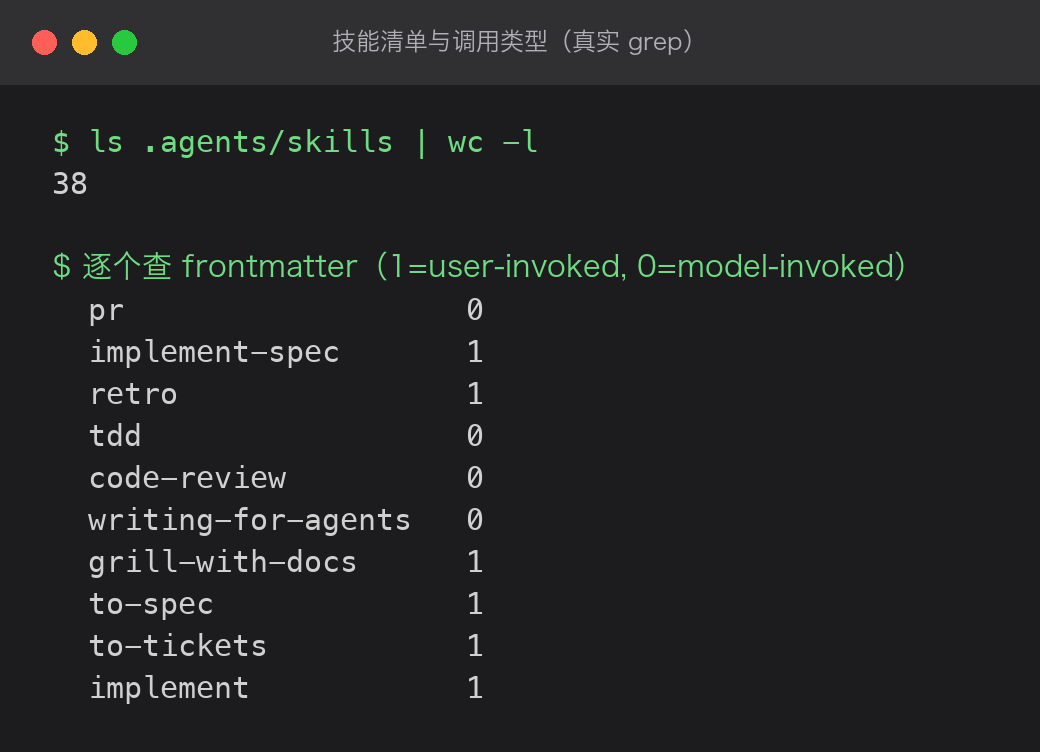
装完想确认哪些能敲、哪些不能,看每个技能 SKILL.md 头部有没有 disable-model-invocation:0 是模型自己判断该用才用,1 是你手动敲。这是逐个 grep 出来的真实结果:
什么时候走哪条路
原文里有一段我觉得最容易被忽略:这些流程没有固定顺序,判断依据是”上下文够不够”,不是”走到第几步”。
这就是开头说的那个”几乎所有人都会犯的错”——把流程当仪式。从第一天开始,不管功能大小,每次都 /to-spec → /to-tickets → /implement 全套走一遍,时间全耗在写文档上,最后还觉得自己”很规范”。
实际就三条路:
小功能(大多数情况):grill-with-docs 对齐需求 → 直接写代码 → /pr → /retro。不用出文档。
大功能:对齐 → to-spec → to-tickets → implement-spec → /pr → /retro。关键是出完 spec 就 clear 掉历史对话、开新会话——文档能带走,聊天记录带不走。
已经在打转(token 烧得快、同一个问题反复冒):只跑 /retro,找出环境缺什么,落成 1–2 个自动检查,再回去干活。
我踩过的坑,一次性列这儿
--skill=不筛选,-y全量装/pr是 model-invoked,敲不出来implement-spec要 issue tracker,没有就让你先 setupimplement-spec内部依赖tdd,别只装它一个- 它清 worktree 但不清
ticket/*分支 CONTEXT.md已改名GLOSSARY.md,老仓库要git mv/resolving-merge-conflicts被移除了,没有替代,让模型自己解- plugin 和 skills.sh 两条安装路线互斥,同时装会有两份
.claude/skills那 38 个符号链接会指向被 gitignore 的.agents/,克隆后全断- 钩子输出别用 Unicode 符号
最后
如果只挑一件事做,我建议是 /retro 加一个提交前检查。十五分钟,副作用为零,而且能立刻验证——你故意提交一段坏代码,看它拦不拦。拦住了,你这仓库就多了一层护栏;没拦住,说明你那条钩子根本没在跑,早发现比晚发现好。
/pr 值得每次提 PR 都套一下,省的是同事的时间。/implement-spec 先别急,等你手上真的有五张以上、还带依赖关系的票再说。
至于开头那个问题——最容易犯的错,真不是不会用哪个技能,是把流程当成了必须走完的仪式。工具是给你省时间的,什么时候该用、什么时候直接上手写,这个判断比技能本身值钱。